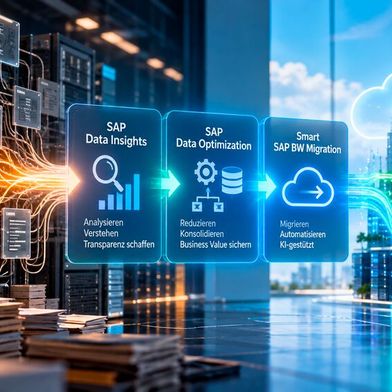
In gewachsenen SAP-BW-Landschaften steckt weit mehr als technischer Code. Sie enthalten über Jahre entstandene Geschäftslogik, Abhängigkeiten und fachliche Regeln. Eine intelligente Migration beginnt deshalb nicht mit der Übertragung einzelner Objekte, sondern mit der Rekonstruktion dieses Wissens.
Eine intelligente SAP-BW-Migration macht Geschäftslogik, Datenbeziehungen und fachlichen Kontext sichtbar, um zu entscheiden, was ins Zielsystem übernommen wird.
Eine SAP-BW-Migration ist kein reiner Datentransport. Sie ist eine Neuimplementierung von Geschäftslogik. In ABAP-Routinen, Transformationen und historisch gewachsenen Datenflüssen steckt Wissen darüber, wie Kennzahlen berechnet, Sonderfälle behandelt und Informationen für Berichte aufbereitet werden. Häufig ist dieses Wissen jedoch nur unvollständig dokumentiert. Es steckt in Systemen, deren Entwickler das Unternehmen längst verlassen haben, oder in technischen Konstruktionen, deren ursprünglicher Zweck kaum noch nachvollziehbar ist. Eine Migration muss daher nicht nur technische Objekte übertragen. Sie muss zunächst rekonstruieren, was das bestehende System tut, warum es dies tut und ob es künftig überhaupt noch benötigt wird.
Eine intelligente Migration kehrt deshalb die übliche Reihenfolge um. Nicht die Übertragung einzelner Objekte steht am Anfang, sondern der Aufbau eines semantischen Modells der vorhandenen BW-Landschaft. Erst wenn Bedeutung, Nutzung und Abhängigkeiten sichtbar sind, lässt sich fundiert entscheiden, was tatsächlich migriert werden muss.
Genau hier liegt die Schwäche vieler herkömmlicher Migrationsprogramme. Sie beginnen mit einer technischen Inventur und arbeiten sich anschließend Objekt für Objekt durch das System. Erst im Projektverlauf wird sichtbar, welche Logik geschäftskritisch ist, welche Strukturen redundant sind und welche Komponenten seit Jahren nicht mehr verwendet werden.
Die Folge: Unternehmen migrieren nicht nur relevante Daten und Prozesse, sondern auch einen großen Teil ihrer technischen Altlasten. Sie bezahlen für deren Analyse, Neuentwicklung, Tests und anschließend erneut für den Betrieb in der Cloud. Der eigentliche Engpass ist daher nicht die Programmierung, sondern fehlendes Wissen über Bedeutung, Nutzung und Abhängigkeiten.
Der erste Schritt besteht darin, die Metadaten der bestehenden Landschaft zu extrahieren und zu standardisieren. Dazu gehören Systemobjekte, Transformationen, Dokumentationen, Formeln, ABAP-Code und strukturelle Informationen. Entscheidend ist, dass Logik und Kontext zusammenbleiben. Eine manuelle Bestandsaufnahme kann zwar Routinen und Objekte erfassen, verliert aber leicht den fachlichen Zusammenhang. Welche Kennzahl beeinflusst eine bestimmte Regel? Welcher Report hängt davon ab? Und welchem Geschäftsprozess dient sie?
Das semantische Modell verbindet diese Informationen. Es macht Abhängigkeiten von der Query-Ebene über CompositeProvider bis zu den zugrunde liegenden DataStore Objects sichtbar, sowohl auf Objekt- als auch auf Feldebene. Dadurch lässt sich nachvollziehen, wo eine Kennzahl entsteht, welche Transformation auf ein Feld wirkt und welche Folgen eine Änderung hätte. Diese Transparenz schafft die Grundlage für die wichtigste Scope-Entscheidung: Was soll erhalten, konsolidiert oder stillgelegt werden?
Vom reduzierten Scope zum Datenprodukt
In nahezu jeder gewachsenen BW-Landschaft befinden sich Objekte, die technisch noch existieren, aber fachlich nicht mehr gebraucht werden. Dazu gehören nicht mehr genutzte Queries, verwaiste DataStore Objects oder längst abgelöste Multi-Provider.
Ohne transparente Lineage und Nutzungsinformationen werden sie häufig vorsorglich mitmigriert. Werden ihre Beziehungen dagegen vorab sichtbar, lässt sich der Scope gezielt reduzieren. Das senkt nicht nur den Migrationsaufwand, sondern auch die späteren Betriebs- und Cloud-Kosten. Erst danach beginnt die Gestaltung der Zielarchitektur. Der zentrale Baustein dafür ist das gesteuerte Datenprodukt. Es handelt sich um ein fachlich ausgerichtetes Asset, das seine eigene Definition, die zugrunde liegende Logik, die vollständige Lineage, klare Verantwortlichkeiten sowie verbindliche Qualitäts- und Governance-Regeln enthält.
Damit wird nicht nur beschrieben, welche Daten bereitgestellt werden. Es ist ebenso festgelegt, wie sie entstehen, wem sie gehören und unter welchen Voraussetzungen sie als verlässlich gelten.
Stand: 08.12.2025
Es ist für uns eine Selbstverständlichkeit, dass wir verantwortungsvoll mit Ihren personenbezogenen Daten umgehen. Sofern wir personenbezogene Daten von Ihnen erheben, verarbeiten wir diese unter Beachtung der geltenden Datenschutzvorschriften. Detaillierte Informationen finden Sie in unserer Datenschutzerklärung.
Einwilligung in die Verwendung von Daten zu Werbezwecken
Ich bin damit einverstanden, dass die Vogel IT-Medien GmbH, Max-Josef-Metzger-Straße 21, 86157 Augsburg, einschließlich aller mit ihr im Sinne der §§ 15 ff. AktG verbundenen Unternehmen (im weiteren: Vogel Communications Group) meine E-Mail-Adresse für die Zusendung von Newslettern und Werbung nutzt. Auflistungen der jeweils zugehörigen Unternehmen können hier abgerufen werden.
Der Newsletterinhalt erstreckt sich dabei auf Produkte und Dienstleistungen aller zuvor genannten Unternehmen, darunter beispielsweise Fachzeitschriften und Fachbücher, Veranstaltungen und Messen sowie veranstaltungsbezogene Produkte und Dienstleistungen, Print- und Digital-Mediaangebote und Services wie weitere (redaktionelle) Newsletter, Gewinnspiele, Lead-Kampagnen, Marktforschung im Online- und Offline-Bereich, fachspezifische Webportale und E-Learning-Angebote. Wenn auch meine persönliche Telefonnummer erhoben wurde, darf diese für die Unterbreitung von Angeboten der vorgenannten Produkte und Dienstleistungen der vorgenannten Unternehmen und Marktforschung genutzt werden.
Meine Einwilligung umfasst zudem die Verarbeitung meiner E-Mail-Adresse und Telefonnummer für den Datenabgleich zu Marketingzwecken mit ausgewählten Werbepartnern wie z.B. LinkedIN, Google und Meta. Hierfür darf die Vogel Communications Group die genannten Daten gehasht an Werbepartner übermitteln, die diese Daten dann nutzen, um feststellen zu können, ob ich ebenfalls Mitglied auf den besagten Werbepartnerportalen bin. Die Vogel Communications Group nutzt diese Funktion zu Zwecken des Retargeting (Upselling, Crossselling und Kundenbindung), der Generierung von sog. Lookalike Audiences zur Neukundengewinnung und als Ausschlussgrundlage für laufende Werbekampagnen. Weitere Informationen kann ich dem Abschnitt „Datenabgleich zu Marketingzwecken“ in der Datenschutzerklärung entnehmen.
Falls ich im Internet auf Portalen der Vogel Communications Group einschließlich deren mit ihr im Sinne der §§ 15 ff. AktG verbundenen Unternehmen geschützte Inhalte abrufe, muss ich mich mit weiteren Daten für den Zugang zu diesen Inhalten registrieren. Im Gegenzug für diesen gebührenlosen Zugang zu redaktionellen Inhalten dürfen meine Daten im Sinne dieser Einwilligung für die hier genannten Zwecke verwendet werden. Dies gilt nicht für den Datenabgleich zu Marketingzwecken.
Recht auf Widerruf
Mir ist bewusst, dass ich diese Einwilligung jederzeit für die Zukunft widerrufen kann. Durch meinen Widerruf wird die Rechtmäßigkeit der aufgrund meiner Einwilligung bis zum Widerruf erfolgten Verarbeitung nicht berührt. Um meinen Widerruf zu erklären, kann ich als eine Möglichkeit das unter https://contact.vogel.de abrufbare Kontaktformular nutzen. Sofern ich einzelne von mir abonnierte Newsletter nicht mehr erhalten möchte, kann ich darüber hinaus auch den am Ende eines Newsletters eingebundenen Abmeldelink anklicken. Weitere Informationen zu meinem Widerrufsrecht und dessen Ausübung sowie zu den Folgen meines Widerrufs finde ich in der Datenschutzerklärung.
Automatisierung braucht fachlichen Kontext
Erst auf dieser semantischen Grundlage kann Automatisierung ihren vollen Nutzen entfalten. KI-gestützte Verfahren können die rekonstruierte Geschäftslogik in SQL oder native Artefakte der Zielplattform überführen. Der Unterschied zu einer reinen Code-Konvertierung ist entscheidend: Übersetzt wird nicht nur die Syntax einer ABAP-Routine, sondern ihre zuvor erfasste fachliche Bedeutung. So entsteht Code, der zur neuen Architektur passt, statt historische Strukturen lediglich in einer anderen Sprache nachzubauen.
Architekten und Entwickler behalten dennoch die Kontrolle. Generierter Code wird versioniert, geprüft und erst nach Freigabe in der Zielumgebung ausgeführt. Automatisierung reduziert den manuellen Aufwand, ersetzt aber weder fachliche Entscheidungen noch Architekturverantwortung. Auch die Validierung wird vorgezogen. Qualitätsregeln, Schemas, Verantwortlichkeiten und Service-Level werden bereits beim Entwurf der Datenprodukte festgelegt. Nach der technischen Umsetzung wird jedes Ergebnis gegen diese Vereinbarungen geprüft. Erfüllt ein Produkt seinen Datenvertrag nicht, wird es überarbeitet und erneut validiert. Probleme werden damit nicht erst nach dem Go-live entdeckt, sondern bereits während der Modellierung.
Das semantische Modell bleibt auch nach der Migration bestehen. Es wird zur lebenden Dokumentation der Datenlandschaft und zeigt, welche Datenprodukte existieren, wie sie zusammenhängen, wer für sie verantwortlich ist und ob sie weiterhin ihre Qualitätsanforderungen erfüllen. Dadurch entstehen wiederverwendbare Assets. Eine für das Finanzreporting definierte Kennzahl kann auch in der Planung, der Konsolidierung oder einer KI-Anwendung genutzt werden, ohne ihre Logik jedes Mal neu rekonstruieren zu müssen.
Die eigentliche Migration führt deshalb nicht nur von SAP BW zu einer neuen Plattform. Sie führt von fragmentierten und unzureichend dokumentierten Daten zu einer Landschaft, in der Bedeutung, Herkunft, Verantwortung und Qualität nachvollziehbar sind. Eine intelligente SAP-BW-Migration kehrt deshalb die klassische Reihenfolge um: Sie rekonstruiert zuerst Kontext, Bedeutung und Abhängigkeiten, entwickelt daraus ein semantisches Zielbild und überträgt erst dann die tatsächlich benötigten Daten und die zugrunde liegende Geschäftslogik.
* Der Autor Dr. Andreas Böhm ist Gründer und CEO von One Data, einem deutschen Softwareunternehmen, das Unternehmen befähigt, fragmentierte Daten aus bestehenden Systemen in vertrauenswürdige, wiederverwendbare Datenprodukte zu transformieren. So entsteht eine verlässliche Datengrundlage für Analytics, Automatisierung und KI. Im Mittelpunkt seiner Arbeit steht eine der größten Herausforderungen beim Einsatz von KI in Unternehmen: die Qualität und Vertrauenswürdigkeit der zugrunde liegenden Daten.